
Инфраструктура • Практика выбора
ИИ-инфраструктура ЦОД: почему растёт спрос на GPU и быструю сеть
Как собрать систему, в которой ускорители не ждут данные
От первого сервера до нескольких вычислительных узлов: что проверить в модели, памяти, сети и серверной до закупки оборудования.
Пилот ИИ-помощника отвечает одному сотруднику быстро. Когда к нему подключается отдел, появляется очередь. Первая реакция — добавить GPU. Но причина может быть в нехватке памяти, настройках обработки запросов или медленной подготовке данных. Сначала нужно понять, чего именно ждёт система.
Это условная ситуация, а не описание проекта QBS. Она показывает главный вопрос закупки: какую работу должна выполнять инфраструктура и при какой нагрузке результат останется приемлемым? Без такого ответа даже мощный сервер может не решить задачу.
Почему ИИ меняет требования к ЦОД
У ИИ-инфраструктуры два разных источника нагрузки. Обучение и дообучение меняют параметры модели; при распределении работы между ускорителями возникает обмен промежуточными результатами. Инференс — применение готовой модели — обслуживает запросы пользователей, распознаёт речь или анализирует изображения. Здесь важны не только скорость вычислений, но и число одновременных запросов, размер входных данных и допустимое ожидание.
GPU хорошо подходят для многих параллельных операций нейросетей. При этом CPU остаются частью системы: обслуживают приложение, готовят данные и могут выполнять подходящие небольшие модели. Формулировка «CPU не справляются с ИИ» слишком груба для выбора оборудования.
Масштаб мировых инвестиций даёт контекст, но не готовую спецификацию. В отчёте IEA Energy and AI (2025) потребление электроэнергии всеми ЦОД в 2024 году оценивалось в 415 ТВт·ч; базовый прогноз на 2030 год — около 945 ТВт·ч. ИИ назван главным драйвером роста. Это глобальная оценка и прогноз, а не статистика российских закупок GPU.
Для отдельной компании практический вывод скромнее: если ИИ становится ежедневным сервисом, нужно заранее проверить не только ускоритель, но и возможность разместить, питать и обслуживать всю систему.
Сначала определите масштаб задачи
| Рабочий сценарий | Что определяет выбор | Что проверить первым |
|---|---|---|
| Помощник по документам, локальная модель | Память модели, длина контекста, одновременные обращения | Помещается ли нагрузка на одном сервере и выдерживается ли время ответа |
| Пакетная обработка видео, речи или изображений | Объём очереди, срок обработки, чтение исходных файлов | Успевают ли хранилище и подготовка данных снабжать GPU работой |
| Одна задача распределена на несколько серверов | Объём и частота обмена между узлами | Даёт ли добавление узлов полезное ускорение на выбранной модели |
Несколько независимых копий модели и одна модель, разделённая между узлами, предъявляют разные требования к сети. В первом случае запросы можно распределять между серверами; во втором обмен становится частью вычисления. Поэтому количество GPU само по себе не определяет нужную скорость портов.
Выбирайте GPU по памяти и платформе, затем по скорости
Начните с конкретной модели и программного стека. Понадобятся название и версия модели, точность вычислений, длина контекста, размер пакета запросов и режим работы. Для инференса память расходуют не только веса, но и рабочие буферы, а у языковых моделей — также KV-кеш, который растёт с контекстом и нагрузкой. Для обучения нужны дополнительные ресурсы под градиенты и состояние оптимизатора.
Условная модель с 8 млрд параметров при двух байтах на параметр требует около 16 ГБ только под веса: 8 млрд × 2 байта. Это десятичные гигабайты, без кеша и служебных расходов. По этой цифре нельзя обещать, что вся рабочая нагрузка поместится в 16 ГБ видеопамяти.
После оценки памяти проверьте исполнение ускорителя. PCIe-карта и SXM-модуль относятся к разным серверным платформам. Важны поддержка конкретного GPU производителем сервера, линии PCIe, расстояние между слотами, питание, воздушный поток и совместимые версии драйверов.
Пример по спецификациям производителя
Даже знакомые названия скрывают разные требования
У NVIDIA L40S указаны 48 ГБ GDDR6 ECC, интерфейс PCIe Gen4 x16 и отсутствие NVLink. У H100 SXM — 80 ГБ памяти, SXM-исполнение и TDP до 700 Вт. Это примеры различий платформ, а не рейтинг ускорителей и не подтверждение наличия.
Нельзя переносить требование PCIe 5.0 или поддержку NVLink на все GPU для ИИ. А значение 700 Вт относится к определённому исполнению H100 — это не общий предел мощности современных ускорителей.
Паспортные FLOPS помогают понять класс устройства, но не заменяют тест. Сравнивайте кандидатов на одинаковой модели, точности, длине входа и выходного ответа. Для пользовательского сервиса фиксируйте время до первого токена и задержку при целевой параллельности; для пакетной задачи — объём работы за час при приемлемом качестве результата.
Быстрая сеть нужна там, где обмен ограничивает работу
Внутри сервера GPU могут обмениваться данными через PCIe и, если платформа это поддерживает, NVLink/NVSwitch. Между серверами используется отдельная сеть. Смешивать эти уровни в спецификации нельзя: наличие быстрого соединения внутри узла не устраняет ограничение между узлами.
Успевают ли поступать файлы, датасеты и контрольные точки?
Как устроена связь ускорителей и где проходят данные?
Сколько времени задача тратит на межузловой обмен?
Для распределённых задач рассматривают InfiniBand или Ethernet с RoCE — передачей RDMA поверх Ethernet. RoCE требует согласованной конфигурации адаптеров и сетевой фабрики, включая управление перегрузками. Покупка коммутатора с подходящей надписью сама по себе не гарантирует нужной производительности; это отражено и в рекомендациях NVIDIA по диагностике сети.
NCCL — программная библиотека коллективного обмена для GPU, а не функция, которую достаточно найти в паспорте коммутатора. Она работает с разными соединениями, включая PCIe, NVLink, InfiniBand и RoCE. Проверять нужно всю цепочку: топологию, адаптеры, драйверы, библиотеку и приложение.
Порты 200 или 400 Гбит/с могут быть обоснованны для конкретного кластера. Для первого сервера с локальной моделью такой выбор не должен быть автоматическим. Зафиксируйте число портов на узел, направления трафика, допустимую переподписку сети и возможность расширения. Кабели и оптику подбирайте по точным артикулам портов, поддерживаемым режимам, расстоянию и совместимости; похожего разъёма недостаточно.
Разбор: второй сервер не дал ожидаемого ускорения
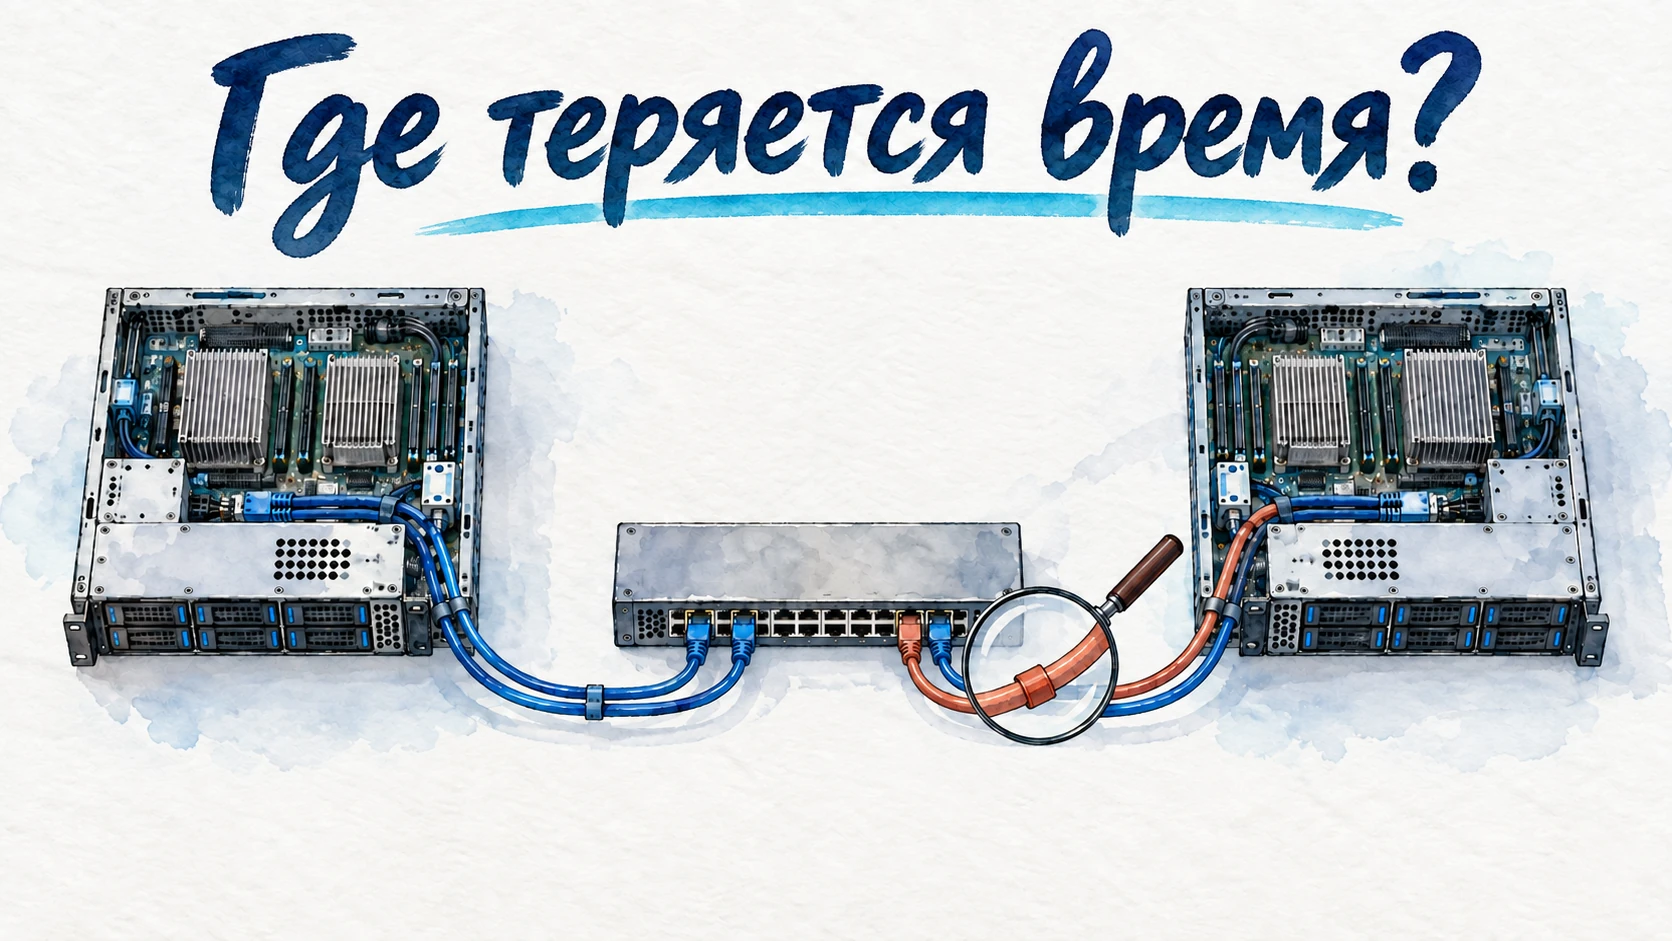
Учебный пример. Ситуация и выводы подготовлены редакцией; это не измерения клиента и не работающая диагностическая система.
Команда перенесла задачу с одного GPU-сервера на два. Ожидали заметно сократить время обработки, но ускорение оказалось небольшим.
«Сразу заменим сеть на 400G — GPU перестанут ждать».
Такое решение не объясняет, где теряется время: на чтении, подготовке данных, вычислении или обмене.
Время выполнения одной и той же задачи на одном и двух узлах; загрузку и память GPU; скорость чтения; время коллективных операций; ошибки и перегрузки сети.
Показать порядок проверки
- Зафиксировать модель, данные, настройки и версии ПО, чтобы сравнение было воспроизводимым.
- Проверить подачу данных: если GPU ждут медленное хранилище или CPU, новая межузловая сеть не устранит первопричину.
- Измерить обмен отдельно. NVIDIA nccl-tests проверяет корректность и производительность коллективных операций. Результат сравнивают с ожидаемым для данной топологии, а не только с номиналом порта.
- Повторить прикладной тест после устранения найденного ограничения. Решение о расширении принять по изменению времени всей задачи.
Вывод: сеть модернизируют, когда измерения подтверждают её ограничение и ожидаемый эффект для приложения.
Питание и охлаждение входят в спецификацию
До заказа оборудования согласуйте с площадкой допустимую мощность на стойку, доступные вводы и PDU, резервирование, параметры охлаждения и требования выбранного сервера. Сумма TDP ускорителей не равна потреблению всей системы: есть CPU, память, накопители, сеть, вентиляторы и потери преобразования.
Воздушное или жидкостное охлаждение выбирают по конкретной платформе и возможностям площадки. Рядом с аппаратной конфигурацией должны быть указаны условия эксплуатации и порядок обслуживания. Иначе сервер может подходить по вычислениям и не подходить по размещению.
Что включить в проверку перед приёмкой
- Воспроизводимая нагрузкаМодель, набор данных, точность, длина контекста, параллельность и версии ПО зафиксированы.
- Критерий результатаДля сервиса — качество ответа, допустимое ожидание и частота ошибок; для пакетной обработки — срок выполнения заданного объёма.
- Работа под нагрузкойПроверены память, температуры, стабильность, скорость хранилища и межузловой обмен, если он используется.
- Условия эксплуатацииСогласованы поддержка, лицензии, доступность комплектующих, восстановление после отказа и ответственные за систему.
Условия теста и пороговые значения лучше согласовать до закупки. Тогда результат приёмки можно сопоставить с исходной задачей, а план расширения — с реальной загрузкой.
Начните с задачи и ограничений площадки
Для первого обсуждения с QBS достаточно короткого описания проекта. Если точной модели или результатов теста ещё нет, укажите это — такие пробелы полезно обнаружить до составления перечня оборудования.
- Что нужно делать: отвечать по документам, обрабатывать видео, обучать или дообучать модель?
- Каков объём работы и сколько пользователей обращаются одновременно?
- Где находятся данные и какие ограничения действуют на их размещение?
- Что уже есть: серверы, сеть, хранилище, питание и охлаждение?
Напишите на info@qbs.ru с темой «Инфраструктура для ИИ-проекта». Первый шаг — сопоставить нагрузку с площадкой и определить, какие характеристики нужно проверить для подбора конфигурации. Наличие, стоимость, сроки и состав работ уточняются под проект.
Написать о задачеПо теме: GPU для ЦОД · Сетевые адаптеры · ИИ-сервер для телекомпании · Центр компетенций по ИИ
Все акварельные сцены созданы с помощью ИИ. Люди и ситуации вымышлены; иллюстрации не изображают сотрудников или проекты QBS. Источники проверены 27 сентября 2026 года. Характеристики приведены для указанных исполнений; окончательную совместимость проверяют по документации выбранного сервера и точным артикулам компонентов.


