Сервер для ИИ начинается с вашей нагрузки
Подбираем серверные платформы и ускорители для локальных нейросетей, корпоративных AI-сервисов и обучения моделей. Сначала определяем требования к вычислениям и памяти, затем — состав оборудования.
Как складывается конфигурация
01 / Нагрузка
Обучение, инференс или работа с документами. Модель, контекст, параллельные запросы.
02 / Память GPU
Веса модели, KV-кэш и рабочие буферы. Запас под выбранную точность и размер пакета.
03 / Платформа
Формат ускорителя, число GPU, питание, охлаждение и совместимость компонентов.
04 / Инфраструктура
Системная RAM, NVMe, сеть и условия размещения сервера.
Какая задача стоит перед сервером
Локальная LLM и RAG
Корпоративный помощник и поиск по документам. Учитываем размер модели, длину контекста, параллельность и место для индекса.
Инференс нейросетей
Работа готовой модели: текст, изображения, речь. Выбор зависит от требуемой задержки и потока запросов.
Обучение и дообучение
Оцениваем память под параметры и оптимизатор, способ дообучения, обмен между GPU и подачу обучающих данных.
Платформы из каталога
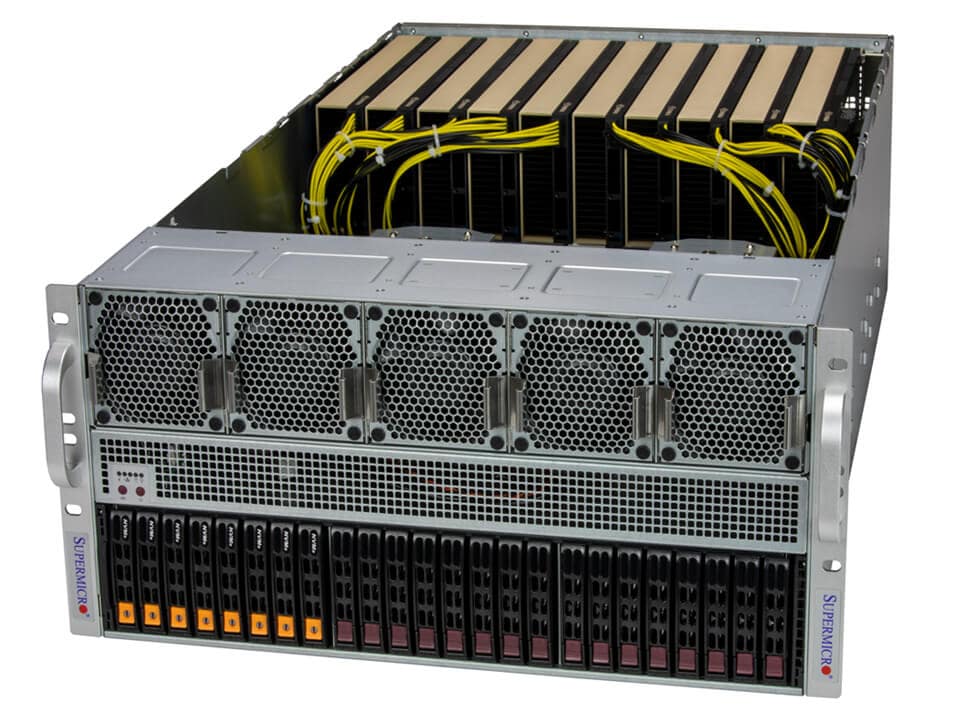
Supermicro SYS-521GE-TNRT
Платформа для конфигураций с GPU PCIe. Состав ускорителей согласуется отдельно.
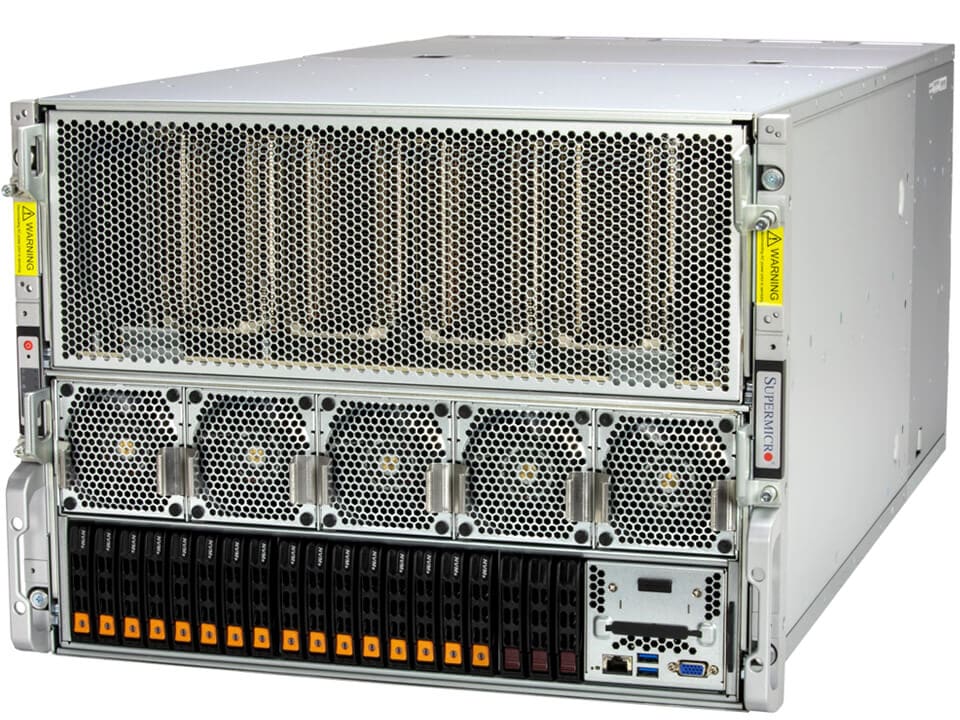
Supermicro SYS-821GE-TNHR
Платформа HGX H100/H200. Выбирается как согласованная многопроцессорная GPU-система.
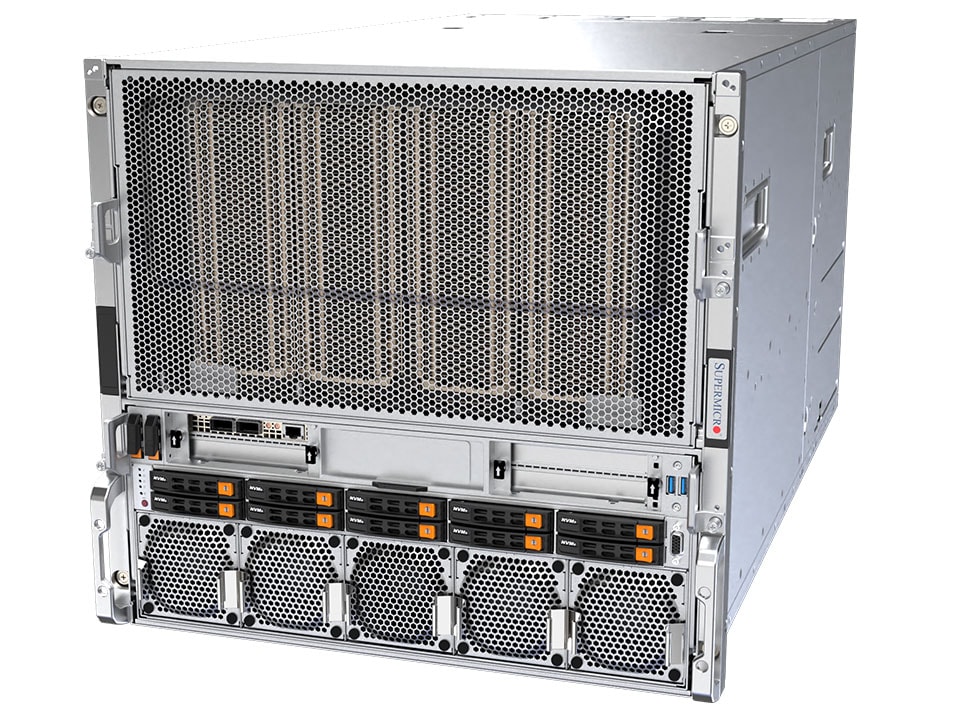
Supermicro SYS-A22GA-NBRT
Платформа NVIDIA HGX B200. Для проекта необходимо проверить размещение, питание и охлаждение.
Что включить в техническое задание
- Модель нейросети, точность весов и максимальная длина контекста.
- Количество одновременных пользователей и целевая скорость ответа.
- Размер датасета, требования к хранению и резервированию.
- Существующее ПО, ОС, ограничения по стойке, электропитанию и охлаждению.
- План роста, бюджет и желаемый срок поставки.
Название GPU само по себе не определяет производительность сервиса. Для оценки нужны параметры нагрузки; при необходимости методику тестирования согласуют отдельно.
Можно ли начать с отдельных ускорителей?
Да, если уже имеющийся сервер поддерживает конкретную карту, её питание и тепловой режим. Проверять нужно список совместимости производителя, доступные слоты и разводку PCIe. Для платформ SXM потребуется соответствующая системная плата и весь совместимый серверный узел.
Выбор по задаче
Для локальной языковой модели определяют память и скорость ответа. В RAG-проекте дополнительно рассчитывают обработку документов, индекс и поиск. Для обучения важны режим изменения весов, обмен между GPU и сохранение контрольных точек. Эти требования описаны отдельно, чтобы сравнивать оборудование по своей нагрузке.
Что входит в серверное решение
| Часть системы | Что должно быть в спецификации |
|---|---|
| Ускорители | Модель, исполнение PCIe/SXM, число GPU и объём памяти каждого. |
| Вычислительный узел | CPU, RAM, накопители, сетевые адаптеры, блоки питания и охлаждение. |
| Программная среда | ОС, драйверы, версия фреймворка, формат модели и лицензии. |
| Размещение | Высота и глубина стойки, доступная мощность, охлаждение и сетевые подключения. |
Название платформы описывает её возможности. Перед закупкой нужен отдельный перечень установленных компонентов: сервер с поддержкой восьми GPU может предлагаться в разных комплектациях. При сравнении цен учитывайте одинаковые GPU, состояние оборудования, гарантию и комплект.
Четыре направления для расчёта проекта
Выберите задачу, чтобы определить состав сервера. Это варианты проектирования: фактический комплект, производительность и условия поставки согласуются после проверки нагрузки и спецификации.
Локальная LLM
Подбор для инференса: модель, точность, контекст, одновременные запросы и допустимое время ответа.
RAG по документам
Архитектура RAG: загрузка документов, OCR, индекс, поиск и генерация. Учитываем рост базы и права доступа.
Видеоаналитика
Ускорители NVIDIA L4: число потоков, кодек, разрешение, частота обработки и нейросетевая модель. Число камер определяем тестом.
Дообучение моделей
Серверы для обучения: метод обучения, датасет, память, межсоединения и контрольные точки.
| Задача | Отправная точка | Что согласовать |
|---|---|---|
| Инференс и RAG | NVIDIA L4 / NVIDIA L40S в совместимом PCIe-сервере | Память модели и контекста, программный стек, резерв ресурсов. |
| Инференс с несколькими GPU | H100 NVL / H200 NVL; пример платформы — Supermicro SYS-521GE-TNRT | Поддерживаемое OEM-исполнение, число карт, мосты, топология и питание. |
| Обучение на HGX | Supermicro SYS-821GE-TNHR с HGX H100 или H200 | SXM-платформа; точная комплектация узла, сеть и инфраструктура. Это другой вариант интеграции, чем PCIe-карты. |
Технические сведения: Supermicro SYS-521GE-TNRT: поддерживаемые GPU. Исполнение и совместимость проверяются по конкретному артикулу.
Технические сведения: Supermicro SYS-821GE-TNHR: платформа HGX. Исполнение и совместимость проверяются по конкретному артикулу.
Подобрать оборудование под вашу задачу
Укажите модель нейросети, сценарий работы, число пользователей, требования к размещению и бюджет. Если нужен конкретный товар — приложите артикул или спецификацию.
Обсудить конфигурациюОтправить техническое заданиеИИ для телекомпании
Поиск по видеоархиву, субтитры и подготовка контента: зарубежные кейсы и выбор GPU-сервера для редакции.